트래픽보다 ‘직접 관계’…NYT와 FT가 보여준 미디어 생존법
by
2026년 9월 28일
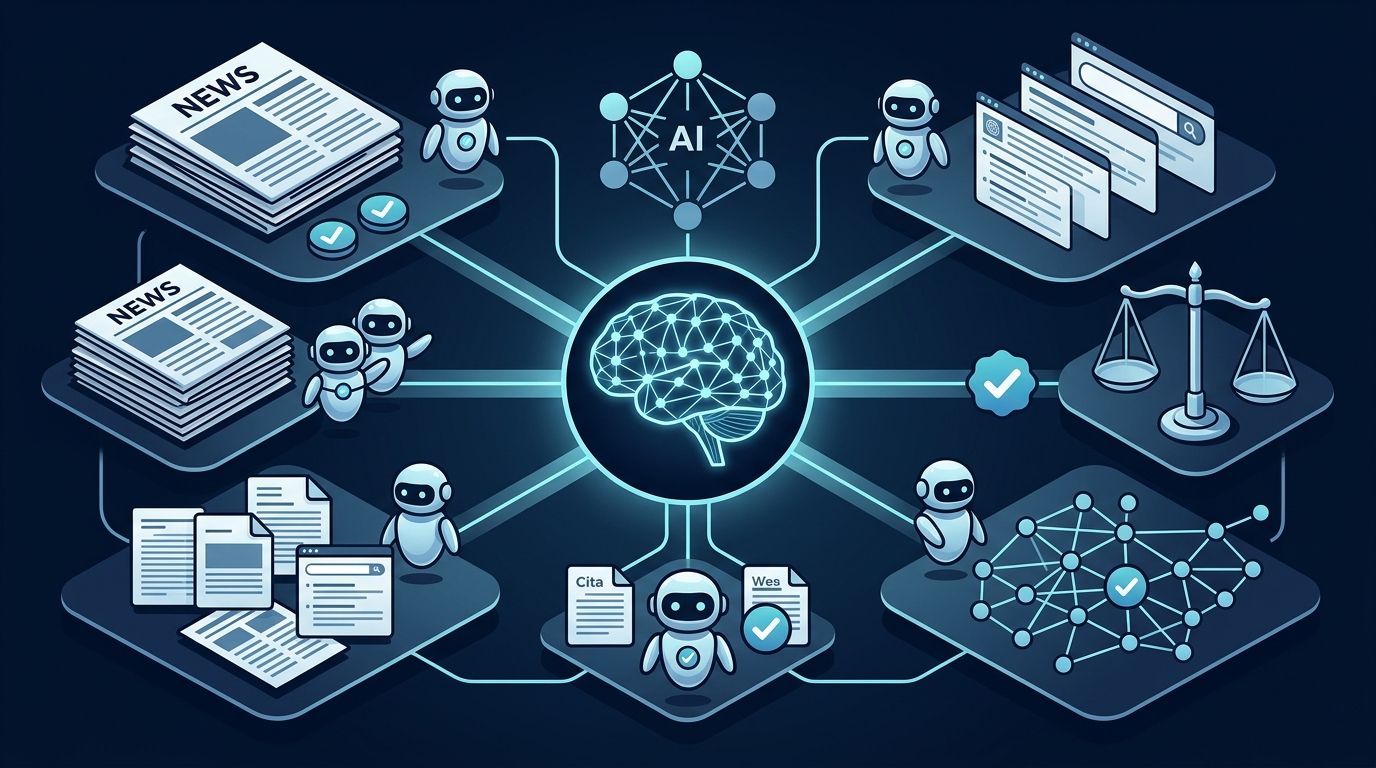
AI 기반 팩트체킹 기술이 단순한 참·거짓 분류에서 벗어나 실시간 검색, 증거 대조, 기사 작성까지 수행하는 방향으로 빠르게 확장되고 있습니다. 2025년 이전에는 정해진 데이터베이스에서 주장을 분류하는 모듈형 파이프라인이 중심이었지만, 2025년에는 생성 AI와 검색 증강 생성(RAG)이 결합됐습니다. 2026년에는 여러 AI 에이전트가 기사를 함께 작성하고, 지식 그래프와 불확실성 설명을 활용하는 구조가 등장했습니다.
제 구글 노트북에 수록된 18개 연구를 분석한 결과, AI 팩트체킹의 정확도는 외부 증거를 검색하고 이를 구조적으로 대조할수록 높아지는 경향을 보였습니다. 다만 환각, 비용, 시간에 따른 정보 변화, 복잡한 논증 구성 등은 여전히 해결되지 않은 과제로 남아 있습니다.
2018~2022년경까지의 AI 팩트체킹 시스템은 대체로 ‘주장 감지 → 증거 검색 → 판정 예측 → 요약 설명 생성’으로 이어지는 4~5단계 파이프라인을 따랐습니다. 시스템은 입력된 문장에서 검증할 만한 주장을 찾아내고, 관련 증거를 검색한 뒤, 해당 주장이 참인지 거짓인지 분류했습니다. 마지막 단계에서는 판정 근거를 짧게 요약하는 방식이 활용됐습니다.
이 시기에는 SVM(Support Vector Machine) 기반의 ClaimBuster와 BERT, RoBERTa, T5 등 지도학습 기반 모델이 주로 사용됐습니다. 특히 판별형 인코더 모델은 입력된 문장과 증거 사이의 관계를 분석하는 데 적합했습니다. 위키피디아 기반의 FEVER(Fact Extraction and VERification) 데이터셋처럼 지식 범위가 제한된 닫힌 지식 베이스에서는 키워드 표면 일치와 자연어 추론(NLI)이 핵심 기법으로 활용됐습니다.
통제된 정적 벤치마크에서는 일정 수준의 성능이 나타났습니다. 그러나 외부 증거 없이 모델이 보유한 지식만으로 실세계 웹의 복잡한 문서를 판단할 때는 정확도가 크게 떨어졌습니다. DeBERTa-v3 같은 인코더 모델은 0.1초 미만의 빠른 처리 속도를 보였지만, 여러 문맥을 합성하거나 복잡한 추론을 수행하는 데는 한계가 있었습니다.
이 때문에 당시 AI는 독립적인 판정자라기보다 전문 팩트체커의 탐색 시간을 줄여주는 인간 개입형 도구로 평가됐습니다. 정적인 지식 출처에 고정된 구조는 실시간으로 변하는 정보나 복잡한 주장을 처리하기 어려웠습니다. 여러 문서의 내용이 서로 충돌할 때 이를 조정하는 능력도 부족했으며, 결과가 참·거짓과 같은 단문 레이블에 머물러 설명력이 낮았습니다.
2025년에는 대규모 언어 모델(LLM)과 실시간 웹 검색을 결합한 검색 증강 생성(RAG)이 주요 흐름으로 부상했습니다. 제 구글 노트북에 수록된 연구 가운데 50.6%가 생성형 RAG를 핵심 기술로 다뤘습니다. 모델이 자체 지식에만 의존하지 않고, 최신 웹 자료를 검색해 판정 과정에 반영하는 구조입니다.
고비용의 초대형 모델 대신 Mistral 7B, Qwen2.5-7B, LLaMA 3.1의 8B·70B 모델 등 소형 언어 모델(SLM)을 미세조정하는 방식도 확산됐습니다. 연구진은 파인튜닝과 QLoRA를 활용해 소형 모델을 특정 팩트체킹 작업에 맞게 조정했습니다. 이 방식은 대규모 모델의 비용과 지연시간을 줄이면서도 검색, 판정, 설명 생성 등 파이프라인의 각 단계에 모델을 배치할 수 있다는 점에서 주목받았습니다.
웹 수집 에이전트와 대화형 사용자 인터페이스를 결합한 플랫폼도 등장했습니다. Veracity와 ClaimCheck 같은 시스템은 실시간으로 자료를 수집하고, 신뢰도 점수와 판정 설명을 화면에 표시하는 방식을 사용했습니다. 검색 결과를 단순히 나열하는 대신 사용자가 판정 과정과 근거를 확인할 수 있도록 설계된 것이 특징입니다.
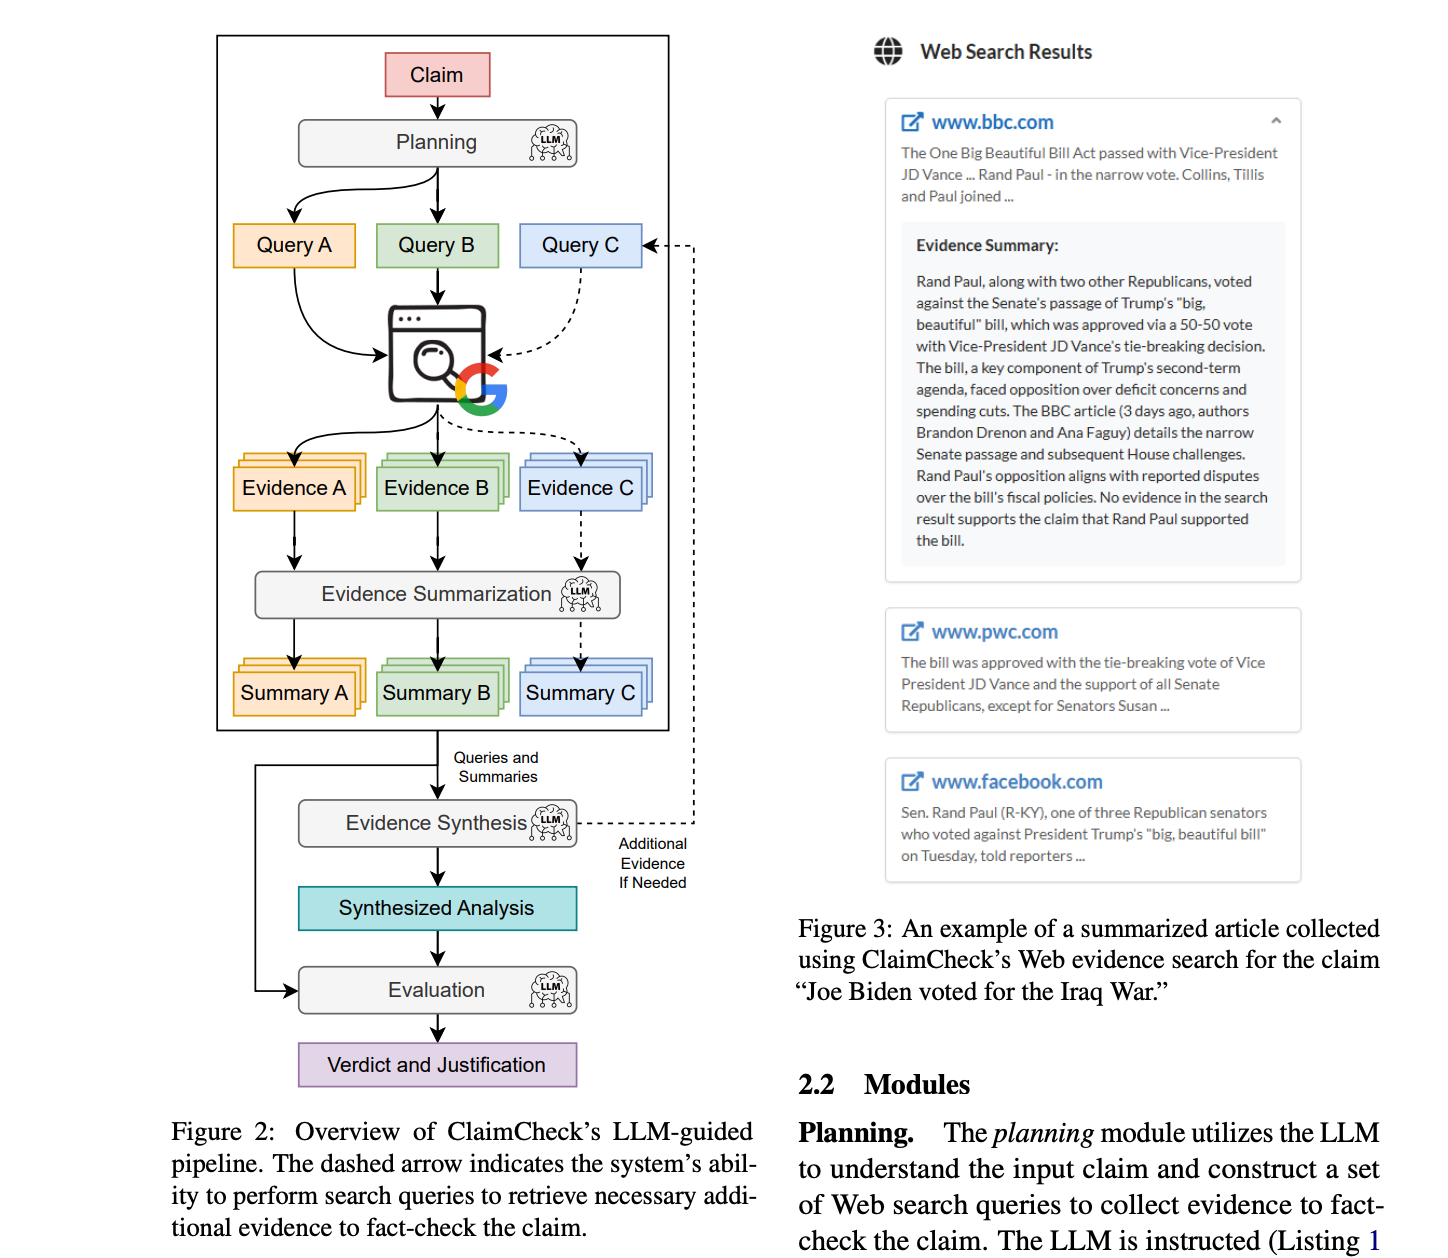
증거 간 충돌을 처리하려는 시도도 이어졌습니다. CONFACT는 출처의 신뢰도와 미디어 배경 정보를 파이프라인에 반영했습니다. 또 일부 연구는 주장을 하나의 문장으로만 다루지 않고, 주장과 전제의 관계를 분석하는 논증 마이닝(Argument Mining)을 결합했습니다.
외부 실시간 증거를 활용한 RAG 시스템은 통제된 환경을 넘어 실세계 벤치마크에서도 성능 향상을 보였습니다. AVeriTeC에서 증거를 제공하지 않은 Naive LLM의 성능은 Qwen2.5-7B가 26.0%, GPT-4o가 53.2%였습니다. 반면 RAG와 소형 언어 모델 미세조정을 결합한 ClaimCheck는 62.6%를 기록했습니다.
| 시스템·모델 | 평가 환경 또는 조건 | 정확도·성능 |
|---|---|---|
| Qwen2.5-7B | AVeriTeC, 증거 미제공 | 26.0% |
| GPT-4o | AVeriTeC, 증거 미제공 | 53.2% |
| ClaimCheck | AVeriTeC, RAG·SLM 미세조정 | 62.6% |
| InFact | AVeriTeC, Knowledge Store 활용 | 72.4% |
| HerO | AVeriTeC | 75.2% |
| LLaMA-3.3-70B + RAG | PolitiFact, 이분법 분류 | 74.7% |
| LLaMA-3.3-70B + RAG | PolitiFact, 5개 클래스 분류 | 40.5% |
| GPT-4o | 별도 평가 | 73.31% |
InFact는 Knowledge Store를 정밀하게 활용해 72.4%를 기록했고, HerO는 75.2%까지 도달했습니다. PolitiFact 1만7,000건 데이터셋에서는 LLaMA-3.3-70B와 RAG를 결합한 시스템이 이분법 분류에서 74.7%의 정확도를 보였습니다. 다만 참, 거짓, 일부 사실 등 5개 클래스로 세분화하면 정확도는 40.5%로 낮아졌습니다.
GPT-4o는 별도 평가에서 73.31%로 가장 높은 정확도를 기록했습니다. 그러나 판정에 확신이 없다는 이유로 결론을 내리지 않은 ‘No Verdict’ 비율도 43.02%에 달했습니다. 이는 높은 평균 정확도가 항상 실무에서의 판정 완결성으로 이어지는 것은 아니라는 점을 보여줍니다.
2025년 연구에서는 AI가 주관적 의견보다 사실처럼 보이는 진술을 더 취약하게 처리하는 구조적 문제가 확인됐습니다. 모델이 문장의 실제 근거보다 어조나 문체 같은 표면적 단서에 의존하는 경향이 나타났기 때문입니다. 특히 ‘사실 진술’은 겉보기에는 객관적이지만, 세부 맥락과 출처를 따져야 하므로 오분류 가능성이 커졌습니다.
| 모델 | 의견 진술 정확도 | 사실형 진술 정확도 |
|---|---|---|
| GPT-4o | 78.79% | 64.83% |
| LLaMA 3.1 70B | 57.48% | 44.97% |
GPT-4o의 경우 의견 진술에 대한 정확도는 78.79%였지만 사실형 진술에서는 64.83%로 낮아졌습니다. LLaMA 3.1 70B도 의견 진술은 57.48%, 사실형 진술은 44.97%를 기록했습니다. 수치상 두 모델 모두 의견보다 사실형 진술에서 낮은 성능을 보였습니다.
RAG를 적용해도 환각 위험은 사라지지 않았습니다. 일부 연구에서는 시스템이 실제로 존재하지 않는 URL이나 논거를 만들어내는 비율이 48.2%에 달했습니다. 대형 모델을 사용할 경우 건당 연산 비용이 GPT-4o 기준 0.46달러에 이르고, 처리 지연시간이 최대 2분에 달하는 문제도 제기됐습니다.
시간에 따라 사실의 의미와 유효성이 바뀌는 문제도 충분히 반영되지 않았습니다. 연구의 60.0%는 사실을 시간에 따라 변하지 않는 정적인 속성으로 다뤘습니다. 이 때문에 개념 변화(Concept Drift)와 모델의 지식 기준 시점(Knowledge Cutoff)에 대응하는 능력이 제한됐습니다.
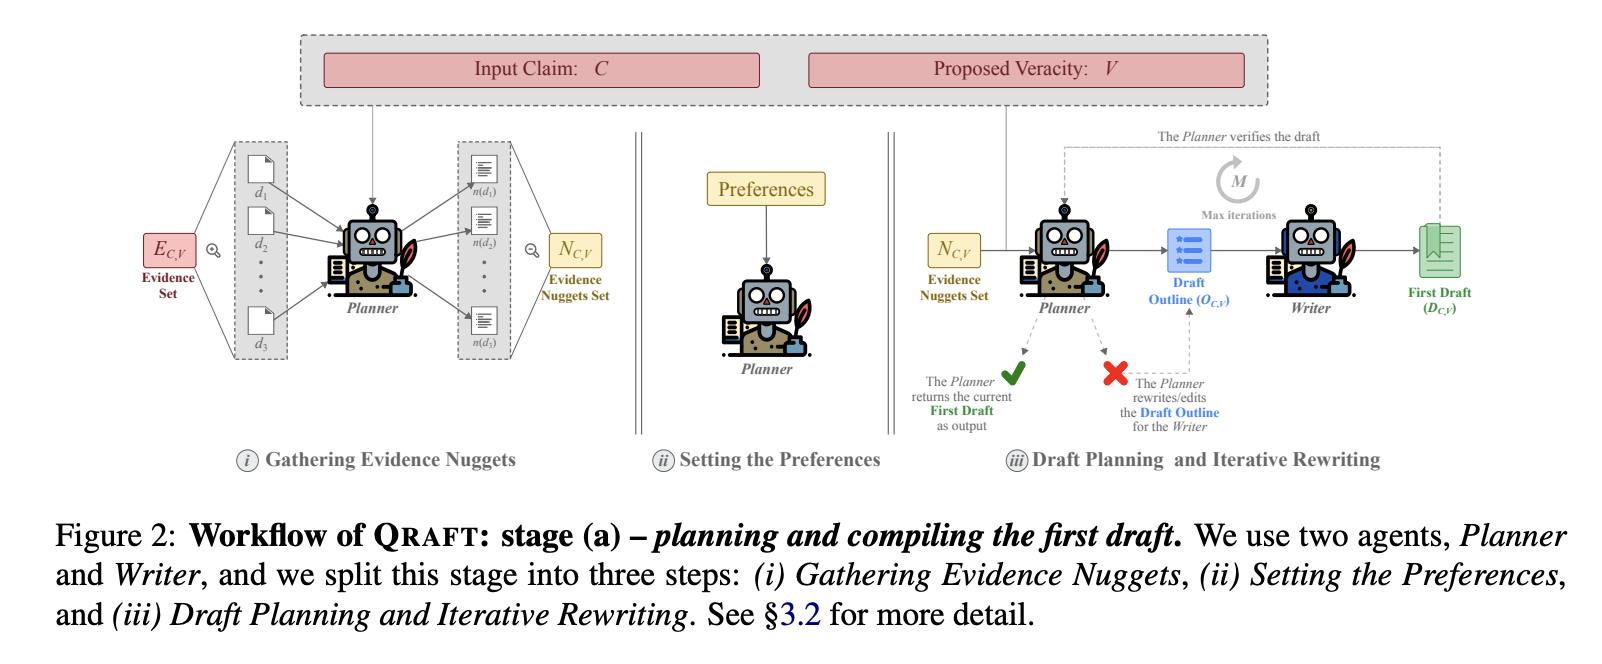
2026년에는 AI 팩트체킹의 범위가 단순한 판정과 근거 요약을 넘어 전체 기사 작성으로 확대됐습니다. QRAFT 다중 에이전트 아키텍처는 기획자(Planner), 작성자(Writer), 편집자(Editor) 역할을 나눈 뒤, 에이전트들이 서로의 결과를 검토하고 수정하도록 설계됐습니다. 이는 전문 저널리스트의 기사 작성 과정을 모방한 구조입니다.
QRAFT는 단문 형태의 판정 설명이 아니라, 주장과 증거를 연결한 완성형 팩트체킹 기사 생성을 목표로 했습니다. 기획자는 필요한 자료와 기사 구성을 정리하고, 작성자는 초안을 만들며, 편집자는 논리와 인용을 검토합니다. 이후 여러 에이전트가 대화형으로 교정하는 방식이 적용됐습니다.
CLUE 프레임워크는 불확실성을 단순한 숫자로 표시하지 않는 접근을 제시했습니다. 증거 문서 사이에서 내용이 일치하거나 충돌하는 구간을 찾아 문장 단위로 매핑하고, Attention Steering을 통해 모델이 불확실성의 원인을 자연어로 설명하도록 했습니다. 사용자는 결과 점수뿐 아니라 어떤 증거가 서로 맞지 않는지 확인할 수 있습니다.
KG-CRAFT는 지식 그래프를 활용한 대조 추론 구조를 제시했습니다. 먼저 주장의 인물, 기관, 사건 등 엔티티와 이들 사이의 관계를 지식 그래프로 구축합니다. 이후 구조적 대조 질문(Contrastive Questions)을 생성하고, 그 질문에 답하는 과정에서 대규모 언어 모델의 추론을 유도합니다.
평가 방식도 정교해졌습니다. Prometheus-2를 활용한 LLM-as-a-Judge 평가가 적용됐고, 현직 저널리스트가 작성된 기사의 게재 가능성(Publishability)을 평가했습니다. 증거를 세부 단위로 나누어 검증하는 Ev2R 원자적 증거 평가 지표도 마련됐습니다.
KG-CRAFT는 LIAR-RAW 데이터셋에서 Naive LLM 대비 F1-score(F1-score(F1 점수)는 AI 및 머신러닝 모델의 성능을 평가할 때 사용하는 대표적인 지표로, 정밀도(Precision)와 재현율(Recall)의 조화평균(Harmonic Mean)값)를 크게 끌어올렸습니다. Llama 3.3 70B는 31.4%에서 73.87%로, Claude 3.7 Sonnet은 27.4%에서 72.36%로 향상됐습니다. 각각 42~44%포인트 수준의 상승폭입니다.
| 모델·시스템 | Naive LLM F1-score | KG-CRAFT 적용 후 F1-score |
|---|---|---|
| Llama 3.3 70B | 31.4% | 73.87% |
| Claude 3.7 Sonnet | 27.4% | 72.36% |
| SmolLM2 1.7B | 별도 비교 조건 | 73.40% |
소형 모델의 성능도 눈에 띄었습니다. 17억 개 매개변수 규모의 SmolLM2는 KG-CRAFT를 적용했을 때 F1-score 73.40%를 기록했습니다. 이는 단일 프롬프트 조건의 초대형 모델인 Naive Claude 3.7 Sonnet의 62.22%보다 높은 수치입니다. 모델의 크기만으로 팩트체킹 성능이 결정되는 것이 아니라, 증거를 조직하고 대조하는 구조가 결과에 큰 영향을 줄 수 있다는 의미입니다.
QRAFT는 FactScore에서 기존 GPT 및 기준선 모델보다 11점 높은 81~85%를 기록했습니다. 환각 인용 비율도 1.29%까지 낮아졌습니다. 다중 에이전트 검토 구조가 인용 오류를 줄이는 데 기여했지만, 모든 오류를 제거한 것은 아닙니다.
2026년 시스템은 증거 데이터를 정확하게 전달하는 데는 진전을 보였지만, 여러 자료를 하나의 설득력 있는 논증으로 결합하는 능력에서는 인간 전문가에 미치지 못했습니다. 수집된 자료를 나열하는 것과 주장의 진위를 논리적으로 입증하는 것은 다른 작업이기 때문입니다. 특히 기사 전체의 흐름과 독자의 이해를 고려한 서사 구성에서 차이가 나타났습니다.
QRAFT가 작성한 기사의 게재 가능성 점수는 3.25점이었습니다. 인간이 작성한 기사는 4.83점을 기록했습니다. 이 결과는 AI가 사실과 인용을 일정 수준 정확하게 제시하더라도, 전문 기자가 작성한 기사와 같은 논리적 연결과 서사적 설득력을 확보하기는 아직 어렵다는 점을 보여줍니다.
복잡한 맥락을 다루는 과정에서도 문제가 남아 있습니다. 주장과 직접 연결되지 않은 간접적 맥락이나 여러 단계로 떨어져 있는 정보가 포함되면, AI가 앞뒤 관계를 유지하지 못하거나 인용을 잘못 연결할 수 있습니다. 이에 따라 전문가의 검토와 감독은 여전히 필요합니다.
다중 에이전트 구조는 정확도와 설명력을 높이는 대신 비용과 지연시간을 늘릴 수 있습니다. 기획, 작성, 편집, 재검토가 여러 차례 반복되면서 단일 모델을 사용하는 시스템보다 연산 부담이 커집니다. 따라서 향후에는 정확도뿐 아니라 처리 속도, 운영 비용, 검토 과정의 투명성까지 함께 평가해야 합니다.
18개 연구가 보여주는 변화는 팩트체킹 AI가 ‘정답을 맞히는 분류기’에서 ‘증거를 찾고 대조하며 설명하는 협업형 시스템’으로 이동하고 있다는 점입니다. 2025년 이전에는 닫힌 지식 베이스와 판별형 인코더가 중심이었지만, 2025년에는 실시간 웹 검색과 생성형 모델의 결합이 핵심이 됐습니다. 2026년에는 지식 그래프, 다중 에이전트, 불확실성 설명이 새로운 구성 요소로 추가됐습니다.
정확도는 외부 증거와 구조적 추론을 결합할수록 높아지는 흐름을 보였습니다. 그러나 높은 F1-score나 정확도가 곧바로 신뢰할 수 있는 기사 작성으로 이어지지는 않았습니다. 사실형 주장 오분류, 가짜 인용, 시간에 따른 정보 변화, 비용과 지연시간, 서사적 논증 부족은 여전히 해결해야 할 핵심 문제입니다.
따라서 현재의 AI 팩트체킹은 인간을 완전히 대체하는 기술이라기보다, 검색과 비교, 초안 작성, 증거 정리를 자동화하는 도구에 가깝습니다. 최종 판정과 게재 여부를 결정하는 과정에서는 출처의 신뢰도와 정보의 시점, 문맥의 적절성, 논증의 완성도를 사람이 확인해야 합니다.
2026년 발표 논문 (총 4개)
2025년 발표 논문 (총 11개)
2025년 이전 발표 논문 (총 3개 / 2021~2022년)
블루닷에이아이의 공동창업자 겸 대표이자, 더코어의 미디어 전담 필자입니다. 고려대를 나와 서울과학기술대에서 박사과정을 수료했습니다. 언론사와 다음커뮤니케이션을 거쳐, 미디어스타트업 엑셀러레이터 '메디아티'에서 이사로 근무했고 구글에서 티칭펠로, 뉴스생태계 파트너십 경험도 쌓았습니다. '트위터 140자의 매직', '혁신저널리즘'(공동저작), '사라진 독자를 찾아서', 'AI와 스타트업', 'AI, 빅테크, 저널리즘' 등을 집필했습니다.