“안녕하세요, AI 비서인데요”… 나 대신 식당에 전화한 ‘피클(Pickle)’ 직접 써보니
by
2026년 11월 8일
📂 공개 데이터에서 실제 업무기록으로
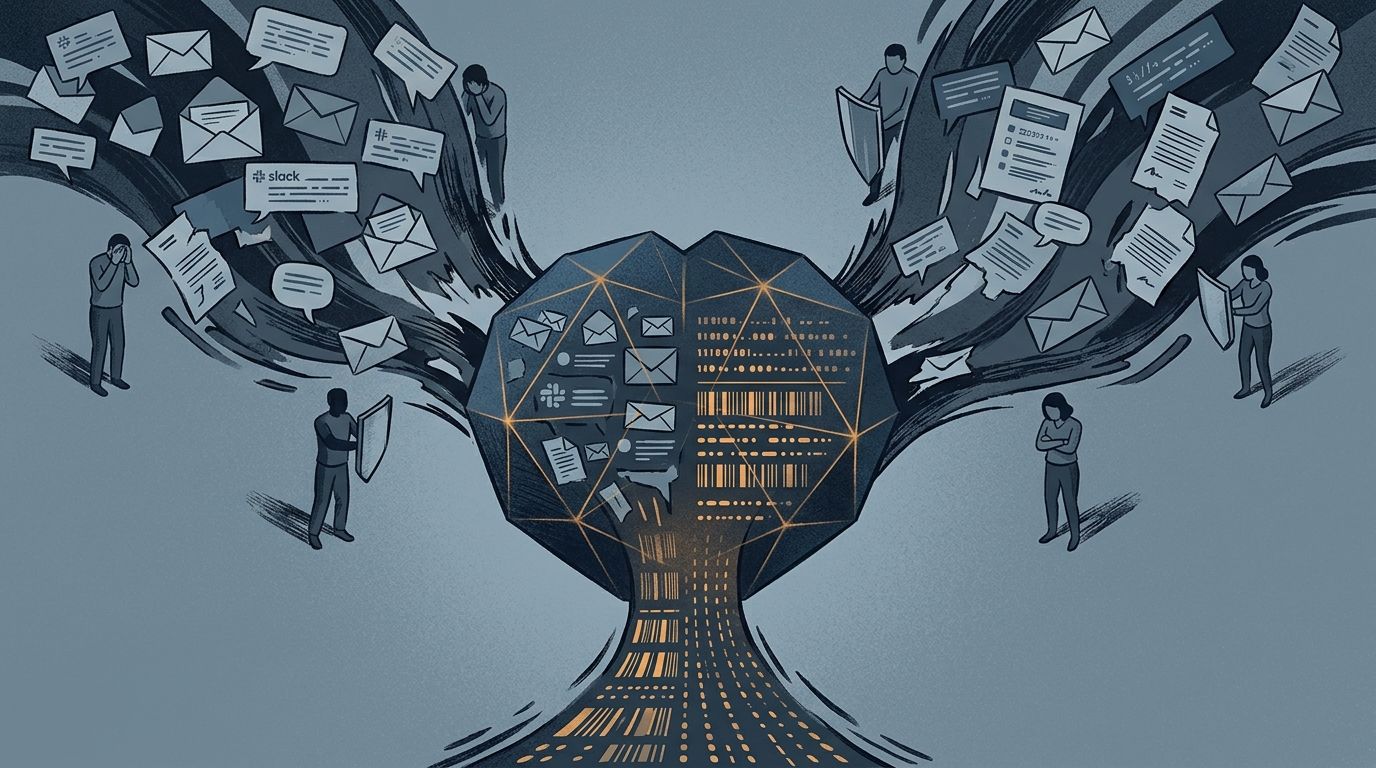
미국 IT 매체 와이어드(WIRED)는 11월 6일 보도에서 머커(Mercor), 마이크로원(Micro1), 핸드셰이크(Handshake) 등 데이터 수집 업체들이 기업의 내부 문서와 이메일, 슬랙(Slack) 메시지, 고객 응대 기록, 통화 기록 등을 확보해 AI 기업에 제공하는 사업을 확대하고 있다고 전했습니다.
WIRED 역시 과거 기사 작성 과정에서 생성된 문서와 이메일, 슬랙 기록 등을 제공하는 대가로 35만~180만 달러(한화 약 4억 8,000만~24억 5,000만 원)를 일회성으로 지급하겠다는 제안을 받았다고 전했는데요. 실제 거래가 완료됐다는 의미는 아니지만 기업의 업무 기록이 AI 학습을 위한 상업적 자산으로 취급되고 있음을 보여주는 사례입니다.
🛡 익명화만으로 해결되지 않는 개인정보 문제
기업 내부 기록을 판매하는 업체들은 개인정보를 식별할 수 있는 요소를 제거한 뒤 데이터를 제공한다고 설명하나, 이메일이나 메신저 대화에는 직원의 건강 문제, 가족 관계, 사적인 일정 등 민감한 정보가 자연스럽게 포함될 수 있습니다. 문서에서 이름이나 계정 정보를 삭제하더라도 대화의 맥락을 통해 개인을 식별하거나 민감한 정보를 추론할 가능성이 있다는 지적이 나옵니다.
WIRED는 파산 절차에 들어간 스피릿항공(Spirit Airlines)의 디지털 자산 매각 사례도 소개했습니다. 매각 대상에는 약 8만 개의 이메일 계정과 5억 건의 내부 메시지, 2,060만 개의 셰어포인트(SharePoint) 파일, 100만 건의 근무시간 기록이 포함됐습니다. 구글과 데이터 수집 기업 마이크로원이 인수 경쟁을 벌였지만, 승무원 노조가 직원들의 사적 정보가 매각 대상에 포함됐다고 문제를 제기하면서 매각 절차가 보류됐습니다.
👥 노동자의 업무 기록이 AI의 학습 재료가 되는 역설
이번 현상에서 주목할 점은 AI 학습 데이터의 원천이 단순한 인터넷 콘텐츠를 넘어 실제 노동 과정에서 만들어진 기록으로 이동하고 있다는 것입니다. 실제 기업의 문서와 메신저 기록에는 업무 처리 방식과 조직 내 의사결정, 고객 대응 과정 등 가상의 데이터로 재현하기 어려운 정보가 담겨 있습니다.
그러나 노동자들이 자신들의 업무 기록이 AI 학습에 활용되는 사실을 알고 동의했는지, 해당 데이터를 기업이 외부에 판매할 권리가 있는지, 데이터를 학습한 AI가 결국 기존 노동자의 업무를 대체하는 데 활용될 수 있는지 등의 문제는 아직 명확한 기준이 정립되지 않았습니다.
AI 기업들이 컴퓨팅 인프라뿐 아니라 고품질 데이터 확보에도 막대한 자본을 투입하면서 데이터의 소유권과 노동자의 동의, 개인정보 보호를 둘러싼 논의 역시 중요한 산업적 쟁점으로 떠오르고 있습니다.

더코어 에디터 (서울대 대학원)